Ein Rechenzentrum, ein Single Point of Failure: Was Drohnen, KI-Angriffe und der Yandex-Ausfall über die Risiken der Zentralisierung verraten
Am Sonntag, dem 11. Oktober, konnte in Almaty und anderen kasachischen Städten niemand ein Yandex-Taxi bestellen, und Kuriere blieben ohne Aufträge. Yandex Go teilte mit, seine Dienste seien vorübergehend nicht verfügbar, und konnte nicht sagen, wann sie wieder laufen würden. Am selben Morgen fielen die Taxis in Tashkent aus, auch in Kirgisistan kam es zu Störungen. Die Ursache lag Tausende Kilometer entfernt in Russland, wo Drohnenangriffe Rechenzentren von Yandex beschädigt hatten.
Das Unternehmen betonte schnell, dass die personenbezogenen Daten kasachischer Nutzer auf Servern in Kasachstan gespeichert sind. Die Daten blieben im Land, der Dienst fiel trotzdem aus. Mit den Worten von Yandex: „Technische Probleme in einer der Komponenten können die Verfügbarkeit der Dienste in mehreren Ländern beeinträchtigen.“
Es ist nicht die erste Geschichte dieser Art im vergangenen Jahr. In Südkorea legte ein Brand in einem einzigen staatlichen Rechenzentrum 647 öffentliche Dienste lahm. Im Nahen Osten schalteten Drohnen drei AWS-Rechenzentren aus, und ein Teil der Daten in Bahrain wurde nie wiederhergestellt. Gleichzeitig führen KI-Agenten inzwischen selbstständig Cyberangriffe durch, Menschen übernehmen dabei überwiegend die Aufsicht.
All diese Fälle haben dieselbe Wurzel: Wenn viel an einem einzigen Punkt hängt, trifft sein Ausfall alle gleichzeitig. Im Folgenden sehen wir uns an, was genau passiert ist, warum Europa die Regierungskommunikation auf föderierte Systeme umstellt und was Kasachstan daraus mitnehmen kann.
Als Bequemlichkeit zum Risiko wurde
Zehn Jahre lang war es sinnvoll, alles in wenigen großen Rechenzentren zu bündeln. Das war günstiger und leichter zu verwalten und lieferte Kapazitäten, die kein einzelnes Unternehmen allein hätte aufbauen können. Doch je mehr Menschen sich auf einen Standort verlassen, desto härter trifft es sie, wenn er ausfällt.
In den vergangenen Jahren sind zu diesem Modell neue Probleme hinzugekommen. Rechenzentren sind zu militärischen Zielen geworden: Die Infrastruktur hinter Banken, öffentlichen Diensten und Telekommunikation wird von Drohnen getroffen wie Kraftwerke. Angreifer verfügen heute über KI, sodass eine kleine Gruppe Dutzende Organisationen gleichzeitig nach Schwachstellen absuchen kann. Und Abhängigkeiten sind nahezu unsichtbar geworden. Oft ahnt ein Unternehmen nicht, dass sein Messenger, sein CRM und sein Zahlungsdienst alle in derselben Region desselben Anbieters laufen. Es erfährt es an dem Tag, an dem dieser Anbieter ausfällt.
Ein Backup im selben Gebäude oder beim selben Anbieter schützt vor nichts davon.
Feuer, Drohnen und Kabel
Um einen digitalen Dienst zu stoppen, muss man ihn nicht hacken. Es genügt, seinen Servern Strom, Kühlung oder Netzanbindung zu nehmen. So sah das in den vergangenen Jahren aus.
| Wann | Was geschah | Wie es endete |
|---|---|---|
| März 2026 | Drohnen trafen zwei AWS-Rechenzentren in den VAE und eines in Bahrain | Lange Ausfälle von Cloud-Diensten. Im September räumte AWS ein, dass ausschließlich in Bahrain gespeicherte Daten nicht wiederhergestellt werden konnten |
| September 2025 | Lithium-Ionen-Batterien gerieten im staatlichen Rechenzentrum NIRS in Daejeon (Südkorea) in Brand | 647 öffentliche Dienste stillgelegt, 96 Systeme zerstört. Ein von Beamten genutztes Speichersystem mit 858 TB hatte kein Backup |
| September 2025 | Im Roten Meer wurden mehrere Unterseekabel durchtrennt | Die Latenz von Microsoft Azure zwischen Asien und Europa stieg, Internetstörungen trafen Asien und den Nahen Osten |
| Oktober 2022 | Brand im Rechenzentrum von SK C&C in Pangyo (Südkorea) | KakaoTalk (rund 53 Millionen Nutzer) und einige Naver-Dienste waren mehrere Stunden lang ausgefallen |
In jedem dieser Fälle gab es ein Backup, nur nicht dort, wo es gebraucht wurde. In Korea liefen rund 40 % der 1.600 staatlichen Systeme an einem einzigen Standort ohne Spiegelung, die Wiederherstellung zog sich über Wochen. In Bahrain behielten nur jene AWS-Kunden ihre Daten, die bereits Kopien in anderen Regionen abgelegt hatten.
KI auf der Seite der Angreifer
Mitte September 2025 deckte Anthropic eine Cyberspionage-Kampagne auf, in der ein KI-Agent den Großteil der Arbeit erledigte. Er suchte selbstständig nach Schwachstellen, schrieb Exploits und sammelte Passwörter. Nach Einschätzung des Unternehmens führte der Agent 80–90 % der taktischen Schritte aus, Menschen griffen nur an entscheidenden Stellen ein. Im Visier standen rund 30 Organisationen, von Technologiekonzernen und Banken bis zu Behörden, und in mehreren Fällen war der Einbruch erfolgreich.
Für zentralisierte Systeme ist das eine schlechte Nachricht. Einen Weg in einen großen Anbieter zu finden, ist billiger und schneller geworden, während die Beute dieselbe bleibt wie zuvor: Zugang zu all seinen Kunden auf einmal. Ein Agent arbeitet rund um die Uhr und gegen viele Ziele parallel, daher bemerken Abwehrmechanismen, die auf menschliches Tempo ausgelegt sind, den Angriff später. Zu den bevorzugten Zielen werden die Kontrollpunkte: Administratorkonten, Cloud-Konsolen, Single-Sign-on-Systeme. Je mehr von ihnen abhängt, desto teurer wird ein einzelner Einbruch.
Auch die Verteidiger setzen KI ein, und das hilft. Doch wenn das ganze System auf einem Punkt ruht, genügt nach wie vor ein einziger erfolgreicher Angriff.
Wenn es ganz ohne Angriff zusammenbricht
Böse Absicht ist nicht einmal nötig. Die beiden größten Ausfälle der vergangenen Jahre begannen mit gewöhnlichen technischen Fehlern.
Im Juli 2024 legte ein fehlerhaftes Update der Sicherheitssoftware von CrowdStrike rund 8,5 Millionen Windows-Rechner lahm. Das ist weniger als ein Prozent aller solchen Geräte, und doch standen Fluggesellschaften, Banken, Bahnen und Handelsketten still. Also genau jene Organisationen, die ihre Gerätebestände zentral über einen einzigen Anbieter verwalten.
Im Oktober 2025 ließ in der meistgenutzten AWS-Region us-east-1 ein seltener Fehler in der DNS-Automatisierung die Datenbank DynamoDB ohne Adresse zurück. In der Folge scheiterten Serverstarts, Lambda-Funktionen und Load Balancer. Bei manchen Kunden hielten die Probleme bis zu 15 Stunden an.
In beiden Fällen hatten die Betroffenen nichts falsch gemacht. Sie hingen schlicht von einem Anbieter oder einer Region ab und konnten nicht schnell umschalten. Wenn zufällige Fehler solchen Schaden anrichten, ist von einem gezielten Angriff auf denselben Punkt mindestens ebenso viel zu erwarten.
Der Yandex-Ausfall: 11.–12. Oktober 2026
Während wir an diesem Text arbeiteten, ereignete sich ein Beispiel deutlich näher an uns. Am 11. und 12. Oktober fiel nahezu das gesamte Yandex-Ökosystem aus: Taxi, Food, Alice, Kinopoisk, Yandex Pay und einige Funktionen von Yandex 360. Die Mitteilung des Unternehmens war knapp: „Die Infrastruktur unserer Rechenzentren wurde beschädigt.“ Nach einem Drohnenangriff ging ein Rechenzentrum in der Region Wladimir in die Notabschaltung. Kurz zuvor waren Standorte in den Regionen Kaluga und Rjasan getroffen worden, und am 8. Oktober meldete Yandex Cloud Stromprobleme in einer seiner Verfügbarkeitszonen.
Bei Yandex laufen Zahlungen, Taxi, Lieferdienste, E-Mail und Dateispeicher auf gemeinsamer Infrastruktur, deshalb fielen sie zusammen aus. Allein zu Yandex Pay und Yandex Go gingen auf einer einzigen Monitoring-Website an einem Tag rund 7.500 Beschwerden ein. Auch Drittunternehmen hatten Probleme und führten sie auf einen Ausfall bei einem Infrastrukturpartner zurück. Die Dienste wurden nacheinander wiederhergestellt, beginnend mit den meistgenutzten. Bis zum Abend liefen Suche, Karten, Taxi und E-Mail wieder, für den Zahlungsdienst wurde jedoch nie ein Zeitplan genannt.
Ein Ausfall ohne Grenzen
Für Zentralasien ist an dieser Geschichte etwas anderes entscheidend: Ein Ausfall in einem Land legte Dienste in den Nachbarländern lahm. Yandex Usbekistan erklärte, seine Dienste liefen auf verteilter Infrastruktur. Fällt in einem Land etwas aus, verlagert sich die Last auf andere Regionen, und dort beginnen ebenfalls Fehler. Betroffen waren Usbekistan, Kasachstan und Kirgisistan. In Tashkent sahen Fahrgäste weder Autos noch Preise, Fahrer konnten Yandex Pro nicht öffnen, Navigation und Busverfolgung funktionierten nicht. Izzat Shukurov, Leiter von Yandex Usbekistan, entschuldigte sich bei den Nutzern und versprach, Zahlungen und Auszahlungen gesondert zu regeln.
Das zeigt deutlich, worin sich ein verteiltes von einem föderierten System unterscheidet. Die Server von Yandex stehen an verschiedenen Orten, werden aber als ein Ganzes gesteuert. Deshalb schlug ein Problem in einem Glied auf Länder durch, in denen es gar keinen Angriff gegeben hatte.
Einige Tage zuvor, vom 8. bis 10. Oktober, war Uzum Market, der größte Marktplatz Usbekistans, mehr als einen Tag lang nicht erreichbar. Bestellungen ließen sich nicht aufgeben, das Händler-Dashboard lud nicht, Lager und Abholstellen standen still. Das Unternehmen selbst führte den Ausfall auf Tests neuer Infrastruktur vor der Hochsaison zurück. Lokale Medien bemerkten, dass der Zeitpunkt mit dem Vorfall bei Yandex Cloud zusammenfiel, doch Uzum hat nie bestätigt, dass es Yandex-Infrastruktur nutzt, ein direkter Zusammenhang lässt sich also nicht behaupten. Die Kosten des Stillstands sind dennoch klar. Das Unternehmen musste die Aufbewahrungsfrist für Bestellungen verlängern, Käufern Promo-Codes ausgeben, Händlern die Logistikgebühren bis Monatsende erlassen und die Betreiber der Abholstellen für entgangenen Gewinn entschädigen.
Das wirft eine Frage für jedes Unternehmen in Kasachstan auf. Wenn morgen der Dienst ausfällt, über den Ihre dienstliche Kommunikation läuft, wie bringen Sie Ihre Leute zusammen?
Föderation: Wofür sich Europa entschieden hat
Von allen Schichten der Infrastruktur ist die Kommunikation vielleicht die empfindlichste. Einen Tag ohne Taxi übersteht man. Eine Krise ohne den Kanal, über den sich das Team abstimmt, nicht.
So funktioniert es
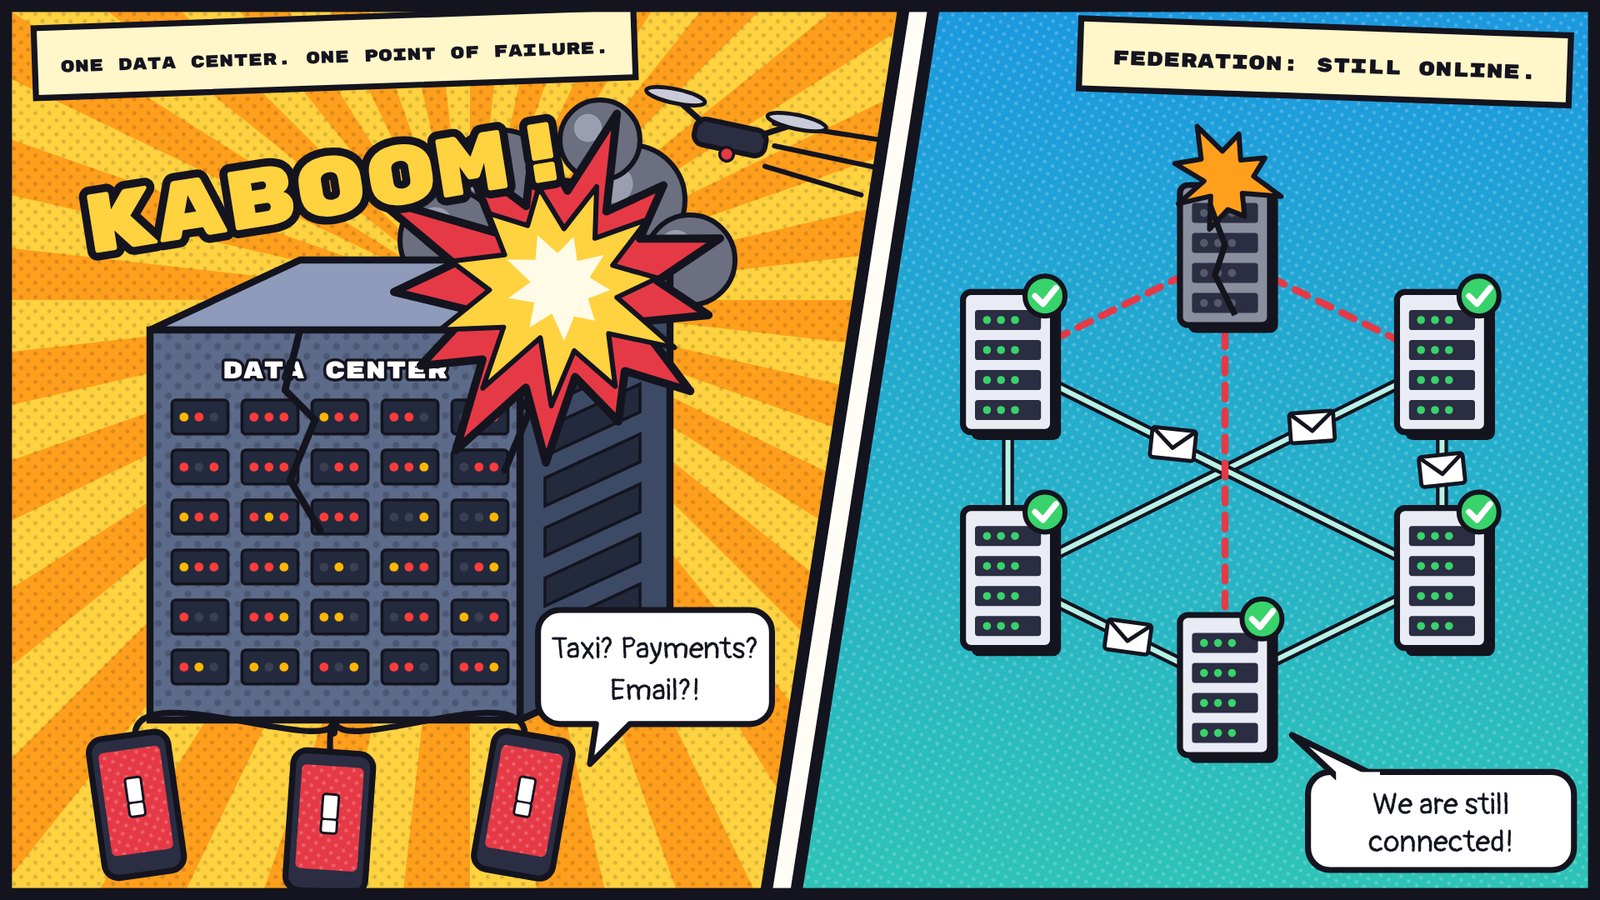
Bei einem zentralisierten Dienst leben alle Nutzer aller Organisationen auf einer Plattform, die einem Unternehmen gehört. In einem föderierten System hat jede Organisation ihren eigenen Server, ihre eigenen Daten und ihre eigenen Regeln. Die Server tauschen Nachrichten über ein gemeinsames Protokoll aus, und zwar nur mit denen, denen sie vertrauen. E-Mail funktioniert seit Jahrzehnten so: Fällt irgendwo ein Mailserver aus, fließt die Post überall sonst weiter.
| Zentralisierter Dienst | Föderiertes System | |
|---|---|---|
| Angriff auf das Rechenzentrum des Anbieters | Alle Kunden fallen gleichzeitig aus | Ein Knoten fällt aus, die übrigen arbeiten weiter |
| Einbruch in einen Server | Legt die Daten aller Kunden offen | Legt die Daten einer Organisation offen |
| Wo die Daten liegen | Beim Anbieter, unter dessen Rechtsordnung | Bei jeder Organisation, innerhalb ihres eigenen Perimeters |
| Kommunikation mit Partnern | Alle müssen denselben Dienst nutzen | Über vertrauenswürdige Verbindungen zwischen Servern |
| Anbieterwechsel | Die gesamte Organisation muss migrieren | Der Knoten wird ersetzt, die Verbindungen bleiben |
Föderation hat ihren Preis. Sie ist aufwendiger aufzubauen, und jemand muss sich um jeden Knoten kümmern: die Organisation selbst oder ihr Integrator. Dafür kann ein einzelner Ausfall oder ein einzelner Angriff nicht mehr alle gleichzeitig stoppen.
Was Europa tut
In den vergangenen zwei Jahren ist föderierte Kommunikation in der EU kein Experiment mehr.
Im Februar 2026 bestätigte die Europäische Kommission, dass sie ein internes Kommunikationssystem auf Basis des offenen Protokolls Matrix als Ausweichkanal vorbereitet. Die Verbindung mit dem Europäischen Parlament läuft bereits. Im Juni beschreibt die Kommission die Plattform in ihrer Mitteilung zur technologischen Souveränität (COM(2026) 503) als in Betrieb genommen und stellt unmissverständlich fest, dass Europas digitales Umfeld „interoperabel, portabel und auf offenen Standards basierend“ sein muss.
Einige Länder waren schon früher so weit. Der französische Regierungsmessenger Tchap verbindet die Ministerien und hat mehr als 300.000 Nutzer. In Deutschland beruhen auf demselben Protokoll der BwMessenger der Bundeswehr (über 100.000 aktive Nutzer) und der TI-Messenger, über den Zehntausende unabhängige Einrichtungen des Gesundheitswesens kommunizieren. Im März 2026 startete Belgien BEAM für Beamte und Militär und rechnet damit, langfristig bis zu 750.000 Menschen anzubinden. Die NATO erprobt denselben Ansatz in ihrem Projekt NICE2 als Ersatz für Consumer-Messenger.
Die Motive der Europäer sind durch und durch praktisch. Sie wollen nicht von einem einzigen Anbieter und einer einzigen Rechtsordnung abhängen, ihre Daten im eigenen Land halten und frei über Behörden- und Ländergrenzen hinweg kommunizieren. Matrix-Mitgründer Matthew Hodgson brachte es so auf den Punkt: Digitale Souveränität sei „von einem ideologischen Ziel zu einem plötzlich ganz konkreten Bedarf geworden“.
Was das für Kasachstan bedeutet
Föderation passt gut zu den kasachischen Vorgaben zur Datenlokalisierung. Die Daten jeder Organisation bleiben auf ihren eigenen Servern im Land, werden aber nicht in einem nationalen Rechenzentrum gebündelt. Ministerien, staatliche Unternehmen, Banken und Auftragnehmer kommunizieren direkt miteinander, während jeder seinen eigenen Knoten betreibt. Partner in Nachbarländern lassen sich über vertrauenswürdige Verbindungen anbinden, ohne die Korrespondenz einer fremden Cloud zu überlassen.
Solche Lösungen gibt es in unserer Region bereits. Ein Beispiel ist aXtura, das unser Team entwickelt: eine Unternehmensplattform mit Messenger, Anrufen, Videokonferenzen und internen Diensten. Dahinter stehen die finnische Astrokvantit Oy und die kasachische Astrokvanta LLP, ein Teilnehmer von Astana Hub, und 2026 haben wir Version 1.0 veröffentlicht. So sind wir an das Problem herangegangen.
Die Plattform lässt sich vollständig auf den eigenen Servern des Kunden installieren, im Land des Kunden und unter seiner Kontrolle. Für Großunternehmen mit Zehntausenden Beschäftigten wird die Installation in einer katastrophenresistenten Konfiguration aufgebaut: Die Server stehen an mehreren Standorten, und fallen einige davon durch Brand, Stromausfall oder Drohnenangriff aus, funktioniert die Kommunikation im Unternehmen weiter. Mit Partnern, Auftragnehmern und Behörden verbindet sich aXtura über Föderation. Jede Seite hat ihre eigene Installation, ihre eigenen Regeln und Zugriffsrechte, und ein Ausfall oder Einbruch an einem Knoten berührt die anderen nicht. Auch eine Anbindung an kompatible Systeme in Nachbarländern ist möglich.
Doch es geht nicht um unser Produkt oder das eines anderen. Europa hat das Prinzip selbst bereits akzeptiert: Die dienstliche Kommunikation einer Organisation darf nicht von einer Drohne über einem fremden Rechenzentrum oder einem Fehler in fremder Automatisierung abhängen.
Was zu tun ist
Die Cloud muss niemand aufgeben. Das Ziel ist bescheidener: die Dinge so einrichten, dass der Verlust eines Standorts, eines Anbieters oder eines Administratorkontos das Geschäft nicht zum Stillstand bringt.
- Erfassen Sie Ihre Abhängigkeiten. Ermitteln Sie für jedes wichtige System, bei welchem Anbieter, in welcher Region und an welchem Standort es läuft. Oft stellt sich heraus, dass E-Mail, Messenger und Buchhaltungssystem alle im selben Rechenzentrum liegen.
- Bewahren Sie Kopien an anderer Stelle auf und prüfen Sie, ob sich daraus tatsächlich wiederherstellen lässt. Eine Kopie sollte an einem anderen Standort liegen, idealerweise bei einem anderen Anbieter, und mindestens eine Version sollte vor Änderungen geschützt oder ganz offline sein. Die 858 TB in Korea hatten gerade deshalb kein Backup, weil es „zu viel“ war.
- Verteilen Sie kritische Systeme auf verschiedene Städte. Sie brauchen mindestens zwei Standorte mit Replikation und ein eingeübtes Failover. Wer noch nie tatsächlich auf das Backup umgeschaltet hat, wird im Ernstfall höchstwahrscheinlich im Stich gelassen.
- Wählen Sie für die Kommunikation eine föderierte Architektur. Ein Knoten pro Organisation und vertrauenswürdige Verbindungen zu Partnern, wie oben beschrieben.
- Beseitigen Sie den einzelnen Kontrollpunkt. Teilen Sie Administratorrechte auf, führen Sie Hardware-Schlüssel für die Anmeldung ein, segmentieren Sie das Netzwerk. Binden Sie KI in das Monitoring ein: Kein Mensch, der von Hand arbeitet, kann mit einem Angriff in Maschinengeschwindigkeit mithalten.
- Legen Sie im Voraus fest, wie Sie im Notbetrieb arbeiten. Welche Funktionen ohne das Hauptrechenzentrum weiterlaufen müssen und über welchen Kanal sich das Team erreicht, wenn alles ausfällt. Dieser Kanal darf nicht von derselben Infrastruktur abhängen.
Was das für Kasachstan und Zentralasien bedeutet
Kasachstan schreibt bereits vor, personenbezogene Daten im Land zu speichern (Gesetz über personenbezogene Daten Nr. 94-V (Artikel 12)), und für staatliche und kritische Systeme gelten gesonderte Bestimmungen des Gesetzes über die Informatisierung. In den Jahren 2025–2026 wurden das Digitalgesetzbuch und das Gesetz über künstliche Intelligenz verabschiedet. Derzeit wird ein Entwurf diskutiert, der Behörden den Umzug in die Cloud nach dem Prinzip Cloud First erlauben würde, sofern die Verschlüsselungsschlüssel in Kasachstan verbleiben.
Lokalisierung beantwortet die Frage, wessen Gesetze für die Daten gelten. Ob die Daten einen Ausfall überstehen, ist eine andere Frage. Liegen die Daten eines ganzen Landes physisch in wenigen großen Rechenzentren, konzentriert sich das Risiko nur noch stärker. Genau das ist die koreanische Geschichte: Alles wurde im Land gehalten, aber in einem Gebäude. Der Yandex-Ausfall zeigte die andere Seite: Die Daten kasachischer Nutzer lagen in Kasachstan, doch der Dienst selbst hing von Rechenzentren in einem anderen Land ab.
Daraus folgen einige praktische Schlussfolgerungen. Daten im Land zu halten heißt nicht, sie an einem Ort zu halten: Ein Ausweichstandort in Almaty für ein System in Astana und umgekehrt sollte zur Norm werden. Auch der Transit zählt: Ein großer Teil des Datenverkehrs der Region läuft über wenige Backbone-Routen, und die Beschädigung eines einzigen Kabels kann ausländische Dienste abschneiden, selbst wenn die Rechenzentren intakt sind. Der Yandex-Ausfall hat ein weiteres Szenario hinzugefügt: Ein Dienst, den die Menschen hier nutzen, kann wegen eines Vorfalls in einem anderen Land ausfallen. Und schließlich lässt sich Resilienz in die Beschaffung einbauen. Staatliche und halbstaatliche Auftraggeber können in ihren technischen Spezifikationen einen getesteten Wiederherstellungsplan, eine getrennte Aufbewahrung der Backups und die Möglichkeit der Installation auf eigenen Servern verlangen.
Zentralasien baut seine digitale Infrastruktur später auf als viele andere, und das hat einen Vorteil. Sie kann von Anfang an verteilt geplant werden, statt nach einer großen Katastrophe umgebaut zu werden, wie es Korea tun musste.
Quellen
- Drone Strikes Damage Amazon Data Centers in the UAE and Bahrain, Bloomberg Tax, März 2026
- Amazon says unable to reactivate UAE, Bahrain data centers, September 2026
- South Korea data centre fire halts 647 government services, BEST Magazine, Oktober 2025
- Microsoft Azure services see major disruption after Red Sea cables cut, TechRadar, September 2025
- Data center fire disrupts services at South Korean tech giants Kakao, Naver, Data Center Knowledge, Oktober 2022
- Disrupting the first reported AI-orchestrated cyber espionage campaign, Anthropic, November 2025
- Microsoft says 8.5M Windows devices were affected by CrowdStrike outage, TechCrunch, Juli 2024
- AWS DynamoDB outage postmortem, InfoQ, November 2025
- Data Localization in Kazakhstan: Issue Brief, AmCham Kazakhstan, Mai 2026
- Major outage at Yandex (auf Russisch), NGS, 12. Oktober 2026
- EU Backs Open Source Matrix For Secure Internal Communications, Open Source For You, Februar 2026
- Communication on European Tech Sovereignty, COM(2026) 503, Europäische Kommission, 3. Juni 2026
- European governments opt for open source alternatives to Big Tech encrypted communications, Computer Weekly
- Belgium rolls out Matrix-based messaging app for government, Resilience Media, März 2026
- “We have faced a serious outage”: head of Yandex Uzbekistan on service disruptions (auf Russisch), Spot, 12. Oktober 2026
- Uzum Market outage coincided with a major Yandex Cloud incident (auf Russisch), Podrobno.uz, 8. Oktober 2026
- Uzum Market reports services restored (auf Russisch), Gazeta.uz, 10. Oktober 2026
- Yandex taxi and courier services stop working in Kazakhstan (auf Russisch), Tengrinews, 11. Oktober 2026
Erstveröffentlichung im Blog von Astana Hub, 12. Oktober 2026.