Un data center, un solo punto di guasto: cosa dicono droni, attacchi IA e il blackout di Yandex sui rischi della centralizzazione
Domenica 11 ottobre, ad Almaty e in altre città del Kazakistan nessuno riusciva a prenotare uno Yandex Taxi, e i corrieri sono rimasti senza ordini. Yandex Go ha comunicato che i servizi erano temporaneamente non disponibili, senza poter dire quando sarebbero tornati attivi. La stessa mattina i taxi si sono fermati a Tashkent, e anche in Kirghizistan si sono registrati disservizi. La causa si trovava a migliaia di chilometri di distanza, in Russia, dove attacchi con droni avevano danneggiato i data center di Yandex.
L’azienda si è affrettata a precisare che i dati personali degli utenti kazaki sono conservati su server in Kazakistan. I dati sono rimasti in patria, eppure il servizio è caduto lo stesso. Con le parole di Yandex: «problemi tecnici in uno dei componenti possono incidere sulla disponibilità dei servizi in diversi Paesi».
Non è la prima storia di questo tipo nell’ultimo anno. In Corea del Sud un incendio in un solo data center governativo ha messo fuori uso 647 servizi pubblici. In Medio Oriente i droni hanno messo fuori servizio tre data center di AWS, e una parte dei dati in Bahrein non è mai stata recuperata. Intanto gli agenti di IA conducono ormai attacchi informatici in autonomia, e agli esseri umani resta soprattutto un ruolo di supervisione.
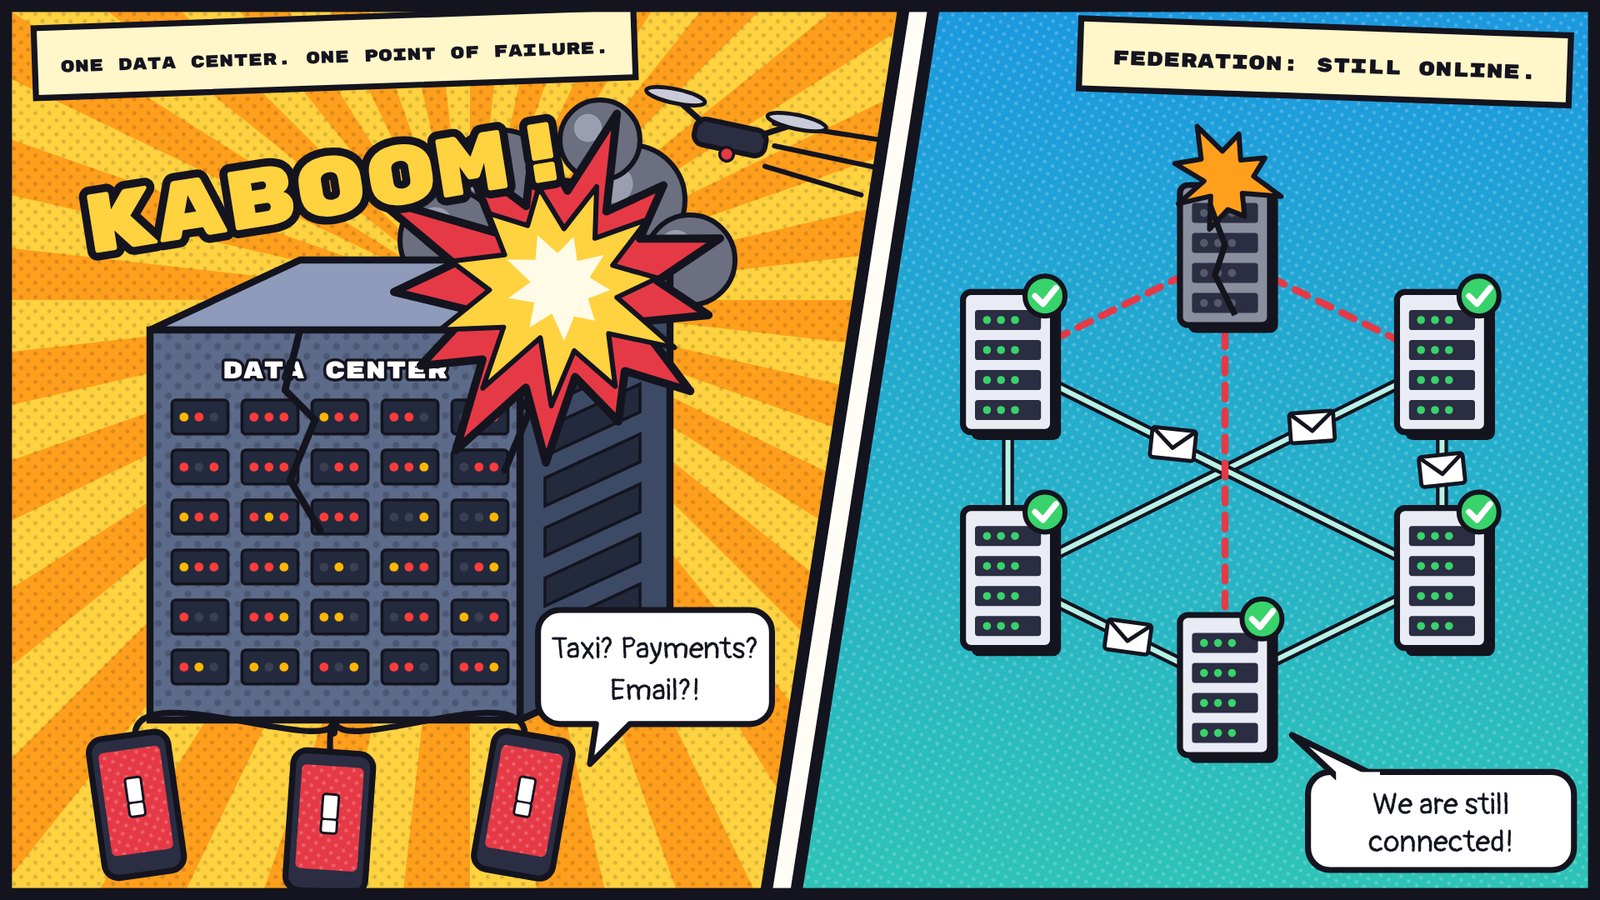
Tutti questi casi hanno la stessa radice: quando molto dipende da un solo punto, perderlo colpisce tutti contemporaneamente. Di seguito vediamo che cosa è successo esattamente, perché l’Europa sta spostando le comunicazioni governative su sistemi federati e che cosa può trarne il Kazakistan.
Quando la comodità è diventata un rischio
Per dieci anni concentrare tutto in pochi grandi data center è stata una scelta sensata. Costava meno, era più facile da gestire e offriva una capacità che nessuna singola azienda avrebbe potuto costruire da sola. Ma più persone si affidano a un unico sito, più fa male quando quel sito si guasta.
Negli ultimi anni il modello ha accumulato nuovi problemi. I data center sono diventati obiettivi militari: l’infrastruttura che sostiene banche, servizi pubblici e telecomunicazioni viene colpita dai droni proprio come le centrali elettriche. Gli attaccanti dispongono ora dell’IA, così un piccolo gruppo può sondare decine di organizzazioni alla ricerca di punti deboli nello stesso momento. E le dipendenze sono diventate quasi invisibili. Spesso un’azienda non sa che il suo messenger, il suo CRM e il suo servizio di pagamento girano tutti nella stessa regione dello stesso fornitore. Lo scopre il giorno in cui quel fornitore va giù.
Un backup nello stesso edificio, o presso lo stesso fornitore, non protegge da nulla di tutto questo.
Incendi, droni e cavi
Per fermare un servizio digitale non serve violarlo. Basta togliere ai suoi server l’alimentazione, il raffreddamento o la connettività. Ecco come è andata negli ultimi anni.
| Quando | Che cosa è successo | Come è finita |
|---|---|---|
| Marzo 2026 | Droni hanno colpito due data center di AWS negli Emirati Arabi Uniti e uno in Bahrein | Lunghe interruzioni dei servizi cloud. A settembre AWS ha ammesso che i dati conservati solo in Bahrein non potevano essere recuperati |
| Settembre 2025 | Batterie agli ioni di litio hanno preso fuoco nel data center governativo NIRS a Daejeon (Corea del Sud) | 647 servizi pubblici fermi, 96 sistemi distrutti. Un sistema di archiviazione da 858 TB usato dai dipendenti pubblici non aveva backup |
| Settembre 2025 | Diversi cavi sottomarini sono stati tranciati nel Mar Rosso | Aumento della latenza di Microsoft Azure tra Asia ed Europa, disservizi internet in Asia e Medio Oriente |
| Ottobre 2022 | Incendio nel data center SK C&C a Pangyo (Corea del Sud) | KakaoTalk (circa 53 milioni di utenti) e alcuni servizi di Naver fuori uso per diverse ore |
In ciascuno di questi casi un backup esisteva, solo che non si trovava dove serviva. In Corea circa il 40% dei 1.600 sistemi governativi girava su un unico sito senza mirror, e il ripristino si è trascinato per settimane. In Bahrein hanno conservato i propri dati solo i clienti di AWS che ne avevano già salvato copie in altre regioni.
L’IA dalla parte degli attaccanti
A metà settembre 2025 Anthropic ha scoperto una campagna di cyberspionaggio in cui un agente di IA svolgeva la maggior parte del lavoro. Cercava vulnerabilità, scriveva exploit e raccoglieva password in autonomia. Secondo le stime dell’azienda, l’agente ha eseguito l’80–90% delle azioni tattiche, mentre gli esseri umani intervenivano solo nei momenti chiave. Gli obiettivi erano circa 30 organizzazioni, dalle grandi aziende tecnologiche alle banche fino alle agenzie governative, e in diversi casi l’intrusione è riuscita.
È una cattiva notizia per i sistemi centralizzati. Trovare un varco in un grande fornitore è diventato più economico e più rapido, mentre il bottino è lo stesso di prima: l’accesso a tutti i suoi clienti in un colpo solo. Un agente lavora 24 ore su 24 e contro molti obiettivi in parallelo, quindi le difese tarate sui ritmi umani si accorgono dell’attacco più tardi. I bersagli principali diventano i punti di controllo: account amministrativi, console cloud, sistemi di single sign-on. Più cose dipendono da loro, più costa una singola violazione.
Anche chi difende usa l’IA, e serve. Ma se l’intero sistema poggia su un solo punto, un singolo attacco riuscito basta ancora.
Quando tutto si rompe senza alcun attacco
Non serve nemmeno la malevolenza. I due blackout più gravi degli ultimi anni sono nati da normali errori tecnici.
Nel luglio 2024 un aggiornamento difettoso del software di sicurezza di CrowdStrike ha messo fuori uso circa 8,5 milioni di computer Windows. Meno dell’uno per cento di tutte le macchine di questo tipo, eppure compagnie aeree, banche, ferrovie e catene commerciali si sono bloccate. In altre parole, proprio le organizzazioni che gestiscono il proprio parco macchine in modo centralizzato tramite un unico fornitore.
Nell’ottobre 2025, nella regione più usata di AWS, us-east-1, un raro bug nell’automazione DNS ha lasciato il database DynamoDB senza indirizzo. A cascata sono falliti l’avvio dei server, le funzioni Lambda e i load balancer. Alcuni clienti hanno avuto problemi per un massimo di 15 ore.
In entrambi i casi le vittime non avevano fatto nulla di sbagliato. Semplicemente dipendevano da un solo fornitore o da una sola regione e non potevano cambiare in fretta. Se errori casuali possono causare danni di questa portata, da un attacco deliberato contro lo stesso punto c’è da aspettarsi almeno altrettanto.
Il blackout di Yandex: 11–12 ottobre 2026
Mentre lavoravamo a questo articolo, un esempio è arrivato molto più vicino a noi. L’11 e il 12 ottobre quasi l’intero ecosistema Yandex ha smesso di funzionare: Taxi, Food, Alice, Kinopoisk, Yandex Pay e alcune funzioni di Yandex 360. La dichiarazione dell’azienda è stata breve: «L’infrastruttura dei nostri data center è stata danneggiata». Dopo un attacco con droni, un data center nella regione di Vladimir è entrato in arresto di emergenza. Poco prima erano stati colpiti siti nelle regioni di Kaluga e Ryazan, e l’8 ottobre Yandex Cloud aveva segnalato problemi di alimentazione in una delle sue zone di disponibilità.
In Yandex pagamenti, taxi, consegne, posta e archiviazione dei file poggiano tutti su un’infrastruttura condivisa, e per questo si sono fermati insieme. Solo Yandex Pay e Yandex Go hanno raccolto circa 7.500 segnalazioni in un giorno su un unico sito di monitoraggio. Anche aziende terze hanno avuto problemi e li hanno attribuiti a un guasto presso un partner infrastrutturale. I servizi sono stati riattivati uno alla volta, a partire dai più usati. In serata Search, Maps, Taxi e Mail funzionavano di nuovo, ma per il ripristino del servizio di pagamento non è mai stata indicata una tempistica.
Un blackout senza confini
Per l’Asia centrale il punto chiave di questa vicenda è un altro: un guasto in un Paese ha fermato i servizi nei Paesi vicini. Yandex Uzbekistan ha spiegato che i suoi servizi girano su un’infrastruttura distribuita. Quando in un Paese si verifica un guasto, il carico si sposta su altre regioni, e lì cominciano gli errori. Sono stati colpiti Uzbekistan, Kazakistan e Kirghizistan. A Tashkent i passeggeri non vedevano né le auto né i prezzi, gli autisti non riuscivano ad aprire Yandex Pro, e la navigazione e il tracciamento degli autobus erano fuori uso. Izzat Shukurov, a capo di Yandex Uzbekistan, si è scusato con gli utenti e ha promesso di occuparsi separatamente di pagamenti e compensi.
Questo mostra chiaramente la differenza tra un sistema distribuito e uno federato. I server di Yandex si trovano in luoghi diversi, ma sono gestiti come un tutt’uno. Per questo un problema in un anello si è propagato a Paesi in cui non c’era stato alcun attacco.
Pochi giorni prima, dall’8 al 10 ottobre, Uzum Market, il più grande marketplace dell’Uzbekistan, è rimasto inattivo per oltre un giorno. Non si potevano effettuare ordini, il pannello dei venditori non si caricava, e magazzini e punti di ritiro erano fermi. L’azienda stessa ha attribuito il blackout ai test di una nuova infrastruttura in vista dell’alta stagione. I media locali hanno notato che i tempi coincidevano con l’incidente di Yandex Cloud, ma Uzum non ha mai confermato di usare l’infrastruttura di Yandex, quindi non si può affermare un collegamento diretto. Il costo del fermo è comunque evidente. L’azienda ha dovuto prolungare la giacenza degli ordini, distribuire codici promozionali agli acquirenti, azzerare le commissioni logistiche per i venditori fino a fine mese e risarcire i gestori dei punti di ritiro per il mancato guadagno.
Il che pone una domanda a ogni azienda del Kazakistan. Se domani il servizio che ospita le vostre conversazioni di lavoro va giù, come farete a riunire le vostre persone?
La federazione: la scelta dell’Europa
Tra tutti i livelli dell’infrastruttura, le comunicazioni sono forse il più sensibile. Si può superare una giornata senza taxi. Non si può superare una crisi senza il canale che il team usa per coordinarsi.
Come funziona
In un servizio centralizzato tutti gli utenti di tutte le organizzazioni vivono su un’unica piattaforma, di proprietà di un’unica azienda. In un sistema federato ogni organizzazione ha il proprio server, i propri dati e le proprie regole. I server si scambiano messaggi tramite un protocollo comune, e solo con quelli di cui si fidano. La posta elettronica funziona così da decenni: se il server di posta di qualcuno si blocca, la posta continua a circolare ovunque altrove.
| Servizio centralizzato | Sistema federato | |
|---|---|---|
| Attacco al data center del fornitore | Tutti i clienti si fermano contemporaneamente | Si ferma un nodo, gli altri continuano a funzionare |
| Violazione di un server | Espone i dati di tutti i clienti | Espone i dati di una sola organizzazione |
| Dove si trovano i dati | Presso il fornitore, sotto la sua giurisdizione | Presso ciascuna organizzazione, all’interno del proprio perimetro |
| Comunicazione con i partner | Tutti devono usare lo stesso servizio | Tramite connessioni fidate tra server |
| Cambio di fornitore | L’intera organizzazione deve migrare | Si sostituisce il nodo, le connessioni restano |
La federazione ha il suo prezzo. È più complessa da costruire, e qualcuno deve occuparsi di ogni nodo: l’organizzazione stessa o il suo integratore. In cambio, un singolo guasto o un singolo attacco non può più fermare tutti contemporaneamente.
Cosa sta facendo l’Europa
Negli ultimi due anni la comunicazione federata nell’UE ha smesso di essere un esperimento.
Nel febbraio 2026 la Commissione europea ha confermato di stare preparando un sistema di comunicazione interna basato sul protocollo aperto Matrix come canale di riserva. Il collegamento con il Parlamento europeo è già attivo. A giugno, nella sua Comunicazione sulla sovranità tecnologica (COM(2026) 503), la Commissione descrive la piattaforma come già avviata e afferma chiaramente che l’ambiente digitale europeo deve essere «interoperabile, portabile e basato su standard aperti».
Alcuni Paesi ci sono arrivati prima. Tchap, il messenger governativo francese, collega i ministeri e conta oltre 300.000 utenti. In Germania lo stesso protocollo è alla base del BwMessenger della Bundeswehr (oltre 100.000 utenti attivi) e di TI-Messenger, che decine di migliaia di strutture sanitarie indipendenti usano per comunicare. Nel marzo 2026 il Belgio ha lanciato BEAM per dipendenti pubblici e militari e prevede di collegare in prospettiva fino a 750.000 persone. La NATO sta testando lo stesso approccio nel progetto NICE2 in sostituzione dei messenger consumer.
Le motivazioni degli europei sono del tutto pratiche. Non vogliono dipendere da un unico fornitore e da un’unica giurisdizione, vogliono tenere i propri dati in casa e vogliono comunicare liberamente tra agenzie e Paesi. Il cofondatore di Matrix Matthew Hodgson l’ha detto così: la sovranità digitale «da obiettivo ideologico è diventata improvvisamente un’esigenza concreta».
Cosa significa per il Kazakistan
La federazione si concilia bene con i requisiti kazaki di localizzazione dei dati. I dati di ogni organizzazione restano sui suoi server all’interno del Paese, ma non vengono concentrati in un unico data center nazionale. Ministeri, società nazionali, banche e fornitori comunicano direttamente tra loro, mentre ciascuno gestisce il proprio nodo. I partner nei Paesi vicini possono essere collegati tramite connessioni fidate, senza consegnare la corrispondenza al cloud di qualcun altro.
Soluzioni di questo tipo esistono già nella nostra regione. Un esempio è aXtura, sviluppata dal nostro team: una piattaforma aziendale con messenger, chiamate, videoconferenze e servizi interni. Alle sue spalle ci sono la finlandese Astrokvantit Oy e la kazaka Astrokvanta LLP, partecipante di Astana Hub, e nel 2026 abbiamo rilasciato la versione 1.0. Ecco come abbiamo affrontato il problema.
La piattaforma può essere installata interamente sui server del cliente, nel Paese del cliente e sotto il suo controllo. Per le grandi aziende con decine di migliaia di dipendenti, l’installazione viene realizzata in una configurazione resiliente ai disastri: i server si trovano in più siti e, se alcuni si guastano per un incendio, un’interruzione di corrente o un attacco con droni, la comunicazione all’interno dell’azienda continua a funzionare. aXtura si collega a partner, fornitori e agenzie governative tramite la federazione. Ogni parte ha la propria installazione, le proprie regole e i propri diritti di accesso, e un guasto o una violazione in un nodo non ha effetti sugli altri. Può anche collegarsi a sistemi compatibili nei Paesi vicini.
Ma qui non si tratta del nostro prodotto né di quello di altri. L’Europa ha già accettato il principio in sé: le comunicazioni di lavoro di un’organizzazione non devono dipendere da un drone sopra il data center di qualcun altro o da un bug nell’automazione di qualcun altro.
Cosa fare
Non c’è bisogno di abbandonare il cloud. L’obiettivo è più modesto: organizzarsi in modo che la perdita di un sito, di un fornitore o di un account amministrativo non fermi l’attività.
- Mappate le vostre dipendenze. Per ogni sistema importante, verificate su quale fornitore, quale regione e quale sito gira. Spesso si scopre che email, messenger e sistema contabile si trovano tutti nello stesso data center.
- Conservate copie altrove e verificate di poterle davvero ripristinare. Una copia deve trovarsi in un sito diverso, idealmente presso un altro fornitore, e almeno una versione deve essere protetta dalle modifiche o del tutto scollegata dalla rete. Quegli 858 TB in Corea sono rimasti senza backup proprio perché erano «troppi».
- Distribuite i sistemi critici in città diverse. Servono almeno due siti con replica e un failover collaudato. Se non siete mai passati davvero al sito di riserva, con ogni probabilità vi tradirà in una vera emergenza.
- Scegliete un’architettura federata per le comunicazioni. Un nodo per ogni organizzazione e connessioni fidate con i partner, come descritto sopra.
- Eliminate il punto di controllo unico. Suddividete i privilegi di amministratore, introducete chiavi hardware per l’accesso, segmentate la rete. Portate l’IA nel monitoraggio: nessun operatore che lavora manualmente può tenere il passo con un attacco che si muove alla velocità di una macchina.
- Decidete in anticipo come operare in modalità di emergenza. Quali funzioni devono sopravvivere senza il data center principale, e quale canale userà il team per comunicare se tutto si ferma. Quel canale non deve dipendere dalla stessa infrastruttura.
Cosa significa per il Kazakistan e l’Asia centrale
Il Kazakistan impone già di conservare i dati personali all’interno del Paese (Legge sui dati personali n. 94-V (articolo 12)), e i sistemi governativi e critici sono soggetti a disposizioni specifiche della Legge sull’informatizzazione. Nel 2025–2026 sono stati adottati il Codice digitale e la Legge sull’intelligenza artificiale. È ora in discussione un progetto che consentirebbe alle agenzie governative di passare al cloud secondo il principio Cloud First, a condizione che le chiavi di cifratura restino in Kazakistan.
La localizzazione risponde alla domanda su quali leggi si applichino ai dati. Se i dati sopravvivano a un guasto è un’altra questione. Se i dati di un intero Paese si trovano fisicamente in pochi grandi data center, il rischio non fa che concentrarsi. È esattamente la storia coreana: tutto era custodito in patria, ma in un solo edificio. Il blackout di Yandex ha mostrato l’altra faccia: i dati degli utenti kazaki erano in Kazakistan, ma il servizio stesso dipendeva da data center in un altro Paese.
Ne derivano alcune conclusioni pratiche. Tenere i dati nel Paese non significa tenerli in un solo posto: un sito di riserva ad Almaty per un sistema ad Astana, e viceversa, dovrebbe diventare la norma. Conta anche il transito: una quota consistente del traffico della regione passa per un numero ridotto di dorsali, e il danneggiamento di un solo cavo può isolare i servizi esteri anche se i data center sono intatti. Il blackout di Yandex ha aggiunto un altro scenario: un servizio usato qui può fermarsi per un incidente in un altro Paese. Infine, la resilienza può essere inserita negli appalti. I committenti governativi e parastatali hanno il diritto di richiedere, nei capitolati tecnici, un piano di ripristino collaudato, la conservazione separata dei backup e la possibilità di installare la soluzione sui propri server.
L’Asia centrale sta costruendo la propria infrastruttura digitale più tardi di molti altri, e questo ha un lato positivo. Può progettarla distribuita fin dall’inizio, invece di ricostruirla dopo un grave disastro, come ha dovuto fare la Corea.
Fonti
- Drone Strikes Damage Amazon Data Centers in the UAE and Bahrain, Bloomberg Tax, marzo 2026
- Amazon says unable to reactivate UAE, Bahrain data centers, settembre 2026
- South Korea data centre fire halts 647 government services, BEST Magazine, ottobre 2025
- Microsoft Azure services see major disruption after Red Sea cables cut, TechRadar, settembre 2025
- Data center fire disrupts services at South Korean tech giants Kakao, Naver, Data Center Knowledge, ottobre 2022
- Disrupting the first reported AI-orchestrated cyber espionage campaign, Anthropic, novembre 2025
- Microsoft says 8.5M Windows devices were affected by CrowdStrike outage, TechCrunch, luglio 2024
- AWS DynamoDB outage postmortem, InfoQ, novembre 2025
- Data Localization in Kazakhstan: Issue Brief, AmCham Kazakhstan, maggio 2026
- Major outage at Yandex (in russo), NGS, 12 ottobre 2026
- EU Backs Open Source Matrix For Secure Internal Communications, Open Source For You, febbraio 2026
- Communication on European Tech Sovereignty, COM(2026) 503, European Commission, 3 giugno 2026
- European governments opt for open source alternatives to Big Tech encrypted communications, Computer Weekly
- Belgium rolls out Matrix-based messaging app for government, Resilience Media, marzo 2026
- “We have faced a serious outage”: head of Yandex Uzbekistan on service disruptions (in russo), Spot, 12 ottobre 2026
- Uzum Market outage coincided with a major Yandex Cloud incident (in russo), Podrobno.uz, 8 ottobre 2026
- Uzum Market reports services restored (in russo), Gazeta.uz, 10 ottobre 2026
- Yandex taxi and courier services stop working in Kazakhstan (in russo), Tengrinews, 11 ottobre 2026
Pubblicato per la prima volta sul blog di Astana Hub, 12 ottobre 2026.