Un centre de données, un point de défaillance : ce que les drones, les attaques par IA et la panne de Yandex disent des risques de la centralisation
Le dimanche 11 octobre, impossible de commander un Yandex Taxi à Almaty et dans d’autres villes du Kazakhstan, et les coursiers se sont retrouvés sans commandes. Yandex Go a indiqué que ses services étaient temporairement indisponibles, sans pouvoir dire quand ils seraient rétablis. Le même matin, les taxis se sont arrêtés à Tachkent, et le Kirghizistan a lui aussi connu des perturbations. La cause se trouvait à des milliers de kilomètres, en Russie, où des attaques de drones avaient endommagé des centres de données de Yandex.
L’entreprise s’est empressée de rappeler que les données personnelles des utilisateurs kazakhs sont stockées sur des serveurs au Kazakhstan. Les données sont restées dans le pays, et le service est tombé quand même. Selon les mots de Yandex, « des problèmes techniques dans l’un des composants peuvent affecter la disponibilité des services dans plusieurs pays ».
Ce n’est pas la première histoire de ce genre en un an. En Corée du Sud, l’incendie d’un seul centre de données public a mis hors service 647 services publics. Au Moyen-Orient, des drones ont détruit trois centres de données d’AWS, et une partie des données stockées à Bahreïn n’a jamais été récupérée. Dans le même temps, des agents d’IA mènent désormais des cyberattaques de manière autonome, les humains se contentant pour l’essentiel de superviser.
Tous ces cas ont la même origine : quand beaucoup de choses dépendent d’un seul point, sa perte frappe tout le monde en même temps. Nous revenons ci-dessous sur ce qui s’est passé exactement, sur les raisons pour lesquelles l’Europe migre ses communications gouvernementales vers des systèmes fédérés et sur ce que le Kazakhstan peut en retenir.
Quand la commodité est devenue un risque
Pendant dix ans, tout regrouper dans une poignée de grands centres de données avait du sens. C’était moins cher, plus simple à gérer, et cela offrait une capacité qu’aucune entreprise ne pouvait bâtir seule. Mais plus les utilisateurs dépendent d’un même site, plus sa défaillance fait mal.
Ces dernières années, ce modèle a hérité de nouveaux problèmes. Les centres de données sont devenus des cibles militaires : l’infrastructure qui fait tourner banques, services publics et télécommunications est frappée par des drones au même titre que les centrales électriques. Les attaquants disposent désormais de l’IA, si bien qu’un petit groupe peut sonder simultanément des dizaines d’organisations à la recherche de failles. Et les dépendances sont devenues presque invisibles. Une entreprise ignore souvent que sa messagerie, son CRM et son service de paiement tournent tous dans la même région du même fournisseur. Elle le découvre le jour où ce fournisseur tombe en panne.
Une sauvegarde dans le même bâtiment, ou chez le même fournisseur, ne protège contre rien de tout cela.
Incendies, drones et câbles
Nul besoin de pirater un service numérique pour l’arrêter. Il suffit de couper l’alimentation, le refroidissement ou la connectivité de ses serveurs. Voici à quoi cela a ressemblé ces dernières années.
| Quand | Ce qui s’est passé | Conséquences |
|---|---|---|
| Mars 2026 | Des drones ont frappé deux centres de données d’AWS aux Émirats arabes unis et un à Bahreïn | Longues interruptions des services cloud. En septembre, AWS a reconnu que les données stockées uniquement à Bahreïn ne pouvaient pas être récupérées |
| Septembre 2025 | Des batteries lithium-ion ont pris feu au centre de données public NIRS de Daejeon (Corée du Sud) | 647 services publics interrompus, 96 systèmes détruits. Un système de stockage de 858 To utilisé par les fonctionnaires n’avait aucune sauvegarde |
| Septembre 2025 | Plusieurs câbles sous-marins ont été sectionnés en mer Rouge | Hausse de la latence de Microsoft Azure entre l’Asie et l’Europe, perturbations d’Internet en Asie et au Moyen-Orient |
| Octobre 2022 | Incendie au centre de données de SK C&C à Pangyo (Corée du Sud) | KakaoTalk (environ 53 millions d’utilisateurs) et certains services de Naver indisponibles pendant plusieurs heures |
Dans chacun de ces cas, une sauvegarde existait, mais pas là où il fallait. En Corée, environ 40 % des 1 600 systèmes gouvernementaux fonctionnaient sur un site unique sans miroir, et la restauration s’est étirée sur des semaines. À Bahreïn, seuls les clients d’AWS qui avaient déjà stocké des copies dans d’autres régions ont conservé leurs données.
L’IA du côté des attaquants
À la mi-septembre 2025, Anthropic a mis au jour une campagne de cyberespionnage dans laquelle un agent d’IA effectuait l’essentiel du travail. Il recherchait des vulnérabilités, écrivait des exploits et collectait des mots de passe de manière autonome. Selon l’estimation de l’entreprise, l’agent a réalisé 80–90 % des actions tactiques, les humains n’intervenant qu’aux moments clés. Une trentaine d’organisations ont été visées, des grands groupes technologiques et des banques jusqu’aux agences gouvernementales, et dans plusieurs cas l’intrusion a réussi.
C’est une mauvaise nouvelle pour les systèmes centralisés. Trouver une porte d’entrée chez un grand fournisseur est devenu moins cher et plus rapide, tandis que le butin reste le même : l’accès à tous ses clients d’un coup. Un agent travaille jour et nuit et contre de nombreuses cibles en parallèle, si bien que des défenses calibrées sur un rythme humain repèrent l’attaque plus tard. Les cibles prioritaires deviennent les points de contrôle : comptes administrateurs, consoles cloud, systèmes d’authentification unique. Plus ils concentrent de dépendances, plus une seule brèche coûte cher.
Les défenseurs utilisent aussi l’IA, et cela aide. Mais si tout le système repose sur un seul point, une seule attaque réussie suffit toujours.
Quand tout casse sans la moindre attaque
La malveillance n’est même pas nécessaire. Les deux plus grandes pannes de ces dernières années ont commencé par de banales erreurs techniques.
En juillet 2024, une mise à jour défectueuse du logiciel de sécurité de CrowdStrike a mis hors service environ 8,5 millions d’ordinateurs Windows. C’est moins de 1 % de l’ensemble de ces machines, et pourtant compagnies aériennes, banques, chemins de fer et commerces se sont retrouvés à l’arrêt. Autrement dit, précisément les organisations qui gèrent leur parc de manière centralisée auprès d’un seul fournisseur.
En octobre 2025, dans la région la plus utilisée d’AWS, us-east-1, un bug rare dans l’automatisation DNS a laissé la base de données DynamoDB sans adresse. Dans la foulée, les lancements de serveurs, les fonctions Lambda et les répartiteurs de charge ont échoué. Certains clients ont subi des problèmes pendant jusqu’à 15 heures.
Dans les deux cas, les victimes n’avaient commis aucune faute. Elles dépendaient simplement d’un seul fournisseur ou d’une seule région et ne pouvaient pas basculer rapidement. Si des erreurs fortuites peuvent causer autant de dégâts, il faut s’attendre à ce qu’une attaque délibérée contre le même point en fasse au moins autant.
La panne de Yandex : 11–12 octobre 2026
Pendant que nous préparions cet article, un exemple bien plus proche est apparu. Les 11 et 12 octobre, la quasi-totalité de l’écosystème Yandex a cessé de fonctionner : Taxi, Food, Alice, Kinopoisk, Yandex Pay et certaines fonctions de Yandex 360. Le communiqué de l’entreprise était laconique : « L’infrastructure de nos centres de données a été endommagée. » Après une attaque de drones, un centre de données de la région de Vladimir s’est mis en arrêt d’urgence. Peu avant, des sites des régions de Kalouga et de Riazan avaient été touchés, et le 8 octobre Yandex Cloud avait signalé des problèmes d’alimentation dans l’une de ses zones de disponibilité.
Chez Yandex, paiements, taxis, livraison, messagerie et stockage de fichiers reposent sur une infrastructure commune, et ils sont donc tombés ensemble. Yandex Pay et Yandex Go ont à eux seuls recueilli environ 7 500 signalements en une journée sur un seul site de surveillance. Des entreprises tierces ont aussi rencontré des problèmes, qu’elles ont attribués à une panne chez un partenaire d’infrastructure. Les services ont été rétablis un par un, en commençant par les plus utilisés. Le soir, Search, Maps, Taxi et Mail fonctionnaient de nouveau, mais aucun calendrier n’a jamais été donné pour le rétablissement du service de paiement.
Une panne sans frontières
Pour l’Asie centrale, l’essentiel de cette histoire est ailleurs : une panne dans un pays a arrêté des services chez ses voisins. Yandex Ouzbékistan a expliqué que ses services fonctionnent sur une infrastructure distribuée. Lorsqu’un pays subit une défaillance, la charge se reporte sur d’autres régions, où des erreurs apparaissent à leur tour. L’Ouzbékistan, le Kazakhstan et le Kirghizistan ont tous été touchés. À Tachkent, les passagers ne voyaient ni les voitures ni les prix, les chauffeurs ne pouvaient pas ouvrir Yandex Pro, et la navigation comme le suivi des bus étaient hors service. Izzat Shukurov, directeur de Yandex Ouzbékistan, a présenté ses excuses aux utilisateurs et promis de traiter séparément la question des paiements et des versements.
Cela montre clairement en quoi un système distribué diffère d’un système fédéré. Les serveurs de Yandex se trouvent à différents endroits, mais ils sont gérés comme un tout. C’est pourquoi un problème sur un maillon s’est propagé à des pays où aucune attaque n’avait eu lieu.
Quelques jours plus tôt, du 8 au 10 octobre, Uzum Market, la plus grande place de marché d’Ouzbékistan, a été indisponible pendant plus d’une journée. Impossible de passer commande, l’espace vendeur ne se chargeait pas, et entrepôts et points de retrait étaient à l’arrêt. L’entreprise a elle-même attribué la panne à des tests de nouvelle infrastructure avant la haute saison. Les médias locaux ont relevé que le calendrier coïncidait avec l’incident de Yandex Cloud, mais Uzum n’a jamais confirmé utiliser l’infrastructure de Yandex, si bien qu’un lien direct ne peut pas être affirmé. Le coût de l’interruption, lui, est clair. L’entreprise a dû prolonger la durée de conservation des commandes, distribuer des codes promo aux acheteurs, exonérer les vendeurs de frais logistiques jusqu’à la fin du mois et indemniser les gérants de points de retrait pour leur manque à gagner.
D’où une question pour chaque entreprise au Kazakhstan. Si le service qui porte vos échanges de travail tombe demain, comment allez-vous réunir vos équipes ?
La fédération : le choix de l’Europe
De toutes les couches de l’infrastructure, les communications sont peut-être la plus sensible. On peut passer une journée sans taxi. On ne traverse pas une crise sans le canal qui permet à l’équipe de se coordonner.
Comment cela fonctionne
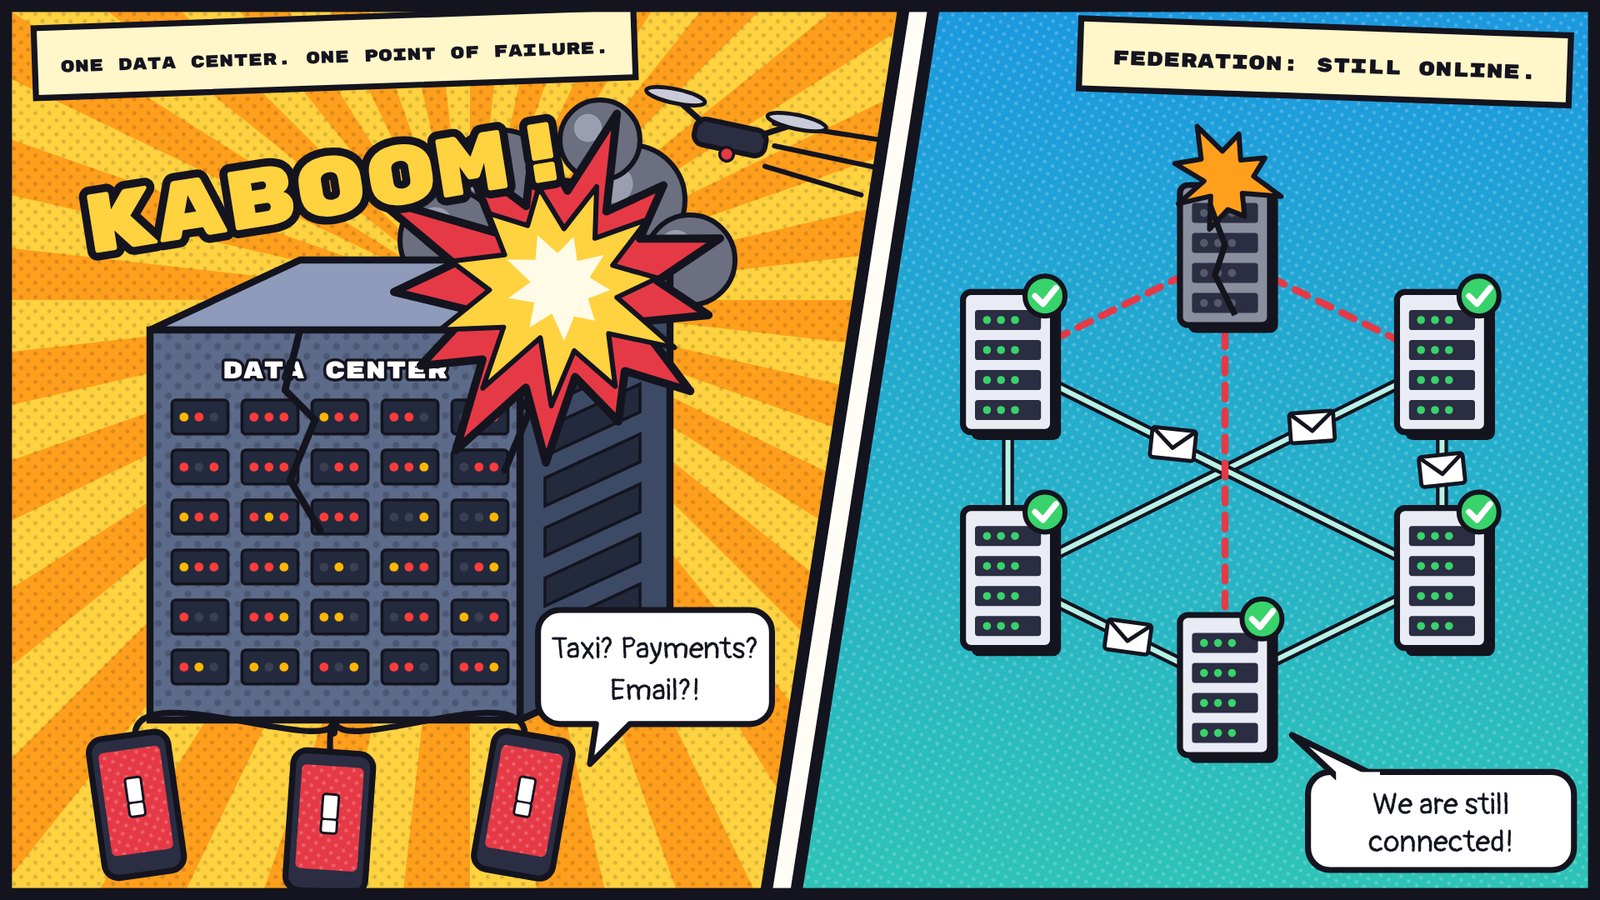
Dans un service centralisé, tous les utilisateurs de toutes les organisations vivent sur une même plateforme appartenant à une seule entreprise. Dans un système fédéré, chaque organisation dispose de son propre serveur, de ses propres données et de ses propres règles. Les serveurs échangent des messages via un protocole commun, et uniquement avec ceux en qui ils ont confiance. Le courrier électronique fonctionne ainsi depuis des décennies : si le serveur de messagerie de quelqu’un tombe en panne, le courrier continue de circuler partout ailleurs.
| Service centralisé | Système fédéré | |
|---|---|---|
| Frappe sur le centre de données du fournisseur | Tous les clients tombent en même temps | Un nœud tombe, les autres continuent de fonctionner |
| Compromission d’un serveur | Expose les données de tous les clients | Expose les données d’une seule organisation |
| Où se trouvent les données | Chez le fournisseur, sous sa juridiction | Chez chaque organisation, dans son propre périmètre |
| Communication avec les partenaires | Tout le monde doit être sur le même service | Par des connexions de confiance entre serveurs |
| Changement de fournisseur | Toute l’organisation doit migrer | Le nœud est remplacé, les connexions restent |
La fédération a un prix. Elle est plus complexe à mettre en place, et il faut que quelqu’un s’occupe de chaque nœud : l’organisation elle-même ou son intégrateur. En contrepartie, une seule panne ou une seule attaque ne peut plus arrêter tout le monde à la fois.
Ce que fait l’Europe
Au cours des deux dernières années, la communication fédérée a cessé d’être une expérimentation dans l’UE.
En février 2026, la Commission européenne a confirmé préparer un système de communication interne fondé sur le protocole ouvert Matrix, comme canal de secours. La liaison avec le Parlement européen fonctionne déjà. En juin, dans sa communication sur la souveraineté technologique (COM(2026) 503), la Commission présente la plateforme comme lancée et affirme clairement que l’environnement numérique de l’Europe doit être « interopérable, portable et fondé sur des normes ouvertes ».
Certains pays ont pris de l’avance. La messagerie gouvernementale française Tchap relie les ministères et compte plus de 300 000 utilisateurs. En Allemagne, le même protocole fait fonctionner BwMessenger de la Bundeswehr (plus de 100 000 utilisateurs actifs) et TI-Messenger, qu’utilisent des dizaines de milliers d’acteurs de santé indépendants pour communiquer. En mars 2026, la Belgique a lancé BEAM pour les fonctionnaires et les militaires et prévoit à terme d’y connecter jusqu’à 750 000 personnes. L’OTAN teste la même approche dans son projet NICE2 pour remplacer les messageries grand public.
Les motivations des Européens sont tout à fait pragmatiques. Ils ne veulent pas dépendre d’un seul fournisseur et d’une seule juridiction, ils veulent garder leurs données chez eux et communiquer librement entre administrations et entre pays. Matthew Hodgson, cofondateur de Matrix, l’a résumé ainsi : la souveraineté numérique « est passée d’un objectif idéologique à un besoin concret et soudain ».
Ce que cela signifie pour le Kazakhstan
La fédération s’accorde bien avec les exigences de localisation des données du Kazakhstan. Les données de chaque organisation restent sur ses propres serveurs dans le pays, sans être regroupées dans un centre de données national unique. Ministères, entreprises nationales, banques et prestataires communiquent directement entre eux, chacun exploitant son propre nœud. Les partenaires des pays voisins peuvent être raccordés par des liaisons de confiance, sans confier la correspondance au cloud de quelqu’un d’autre.
Des solutions de ce type existent déjà dans notre région. L’une d’elles est aXtura, que développe notre équipe : une plateforme d’entreprise avec messagerie, appels, visioconférence et services internes. Elle est portée par la société finlandaise Astrokvantit Oy et la société kazakhe Astrokvanta LLP, participante d’Astana Hub, et nous avons publié la version 1.0 en 2026. Voici comment nous avons abordé le problème.
La plateforme peut être installée entièrement sur les serveurs du client, dans le pays du client et sous son contrôle. Pour les grandes entreprises de plusieurs dizaines de milliers de salariés, l’installation est déployée dans une configuration résiliente aux sinistres : les serveurs sont répartis sur plusieurs sites, et si certains tombent à cause d’un incendie, d’une coupure de courant ou d’une frappe de drone, la communication au sein de l’entreprise continue de fonctionner. aXtura se connecte aux partenaires, prestataires et administrations par la fédération. Chaque partie dispose de sa propre installation, de ses propres règles et droits d’accès, et une défaillance ou une compromission sur un nœud n’affecte pas les autres. La plateforme peut aussi se connecter à des systèmes compatibles dans les pays voisins.
Mais il ne s’agit pas de notre produit ni de celui de quelqu’un d’autre. L’Europe a déjà adopté le principe lui-même : les communications de travail d’une organisation ne doivent pas dépendre d’un drone au-dessus du centre de données d’un autre ou d’un bug dans l’automatisation d’un autre.
Que faire
Il n’est pas nécessaire de renoncer au cloud. L’objectif est plus modeste : s’organiser pour que la perte d’un site, d’un fournisseur ou d’un compte administrateur n’arrête pas l’activité.
- Cartographiez vos dépendances. Pour chaque système important, identifiez le fournisseur, la région et le site sur lesquels il fonctionne. Il s’avère souvent que la messagerie électronique, la messagerie instantanée et le système comptable se trouvent tous dans le même centre de données.
- Conservez des copies ailleurs et vérifiez que vous pouvez réellement restaurer à partir d’elles. Une copie doit se trouver sur un autre site, idéalement chez un autre fournisseur, et au moins une version doit être protégée contre les modifications ou complètement déconnectée. Ces 858 To en Corée n’étaient pas sauvegardés précisément parce qu’il y en avait « trop ».
- Répartissez les systèmes critiques entre différentes villes. Il faut au moins deux sites avec réplication et une bascule répétée. Si vous n’avez jamais réellement basculé vers le site de secours, il vous fera très probablement défaut lors d’une véritable urgence.
- Choisissez une architecture fédérée pour les communications. Un nœud par organisation et des connexions de confiance avec les partenaires, comme décrit plus haut.
- Supprimez le point de contrôle unique. Séparez les privilèges d’administration, introduisez des clés matérielles pour la connexion, segmentez le réseau. Intégrez l’IA à la surveillance : aucun humain travaillant manuellement ne peut suivre une attaque qui avance à la vitesse d’une machine.
- Décidez à l’avance comment vous fonctionnerez en mode dégradé. Quelles fonctions doivent survivre sans le centre de données principal, et quel canal l’équipe utilisera pour se joindre si tout tombe. Ce canal ne doit pas dépendre de la même infrastructure.
Ce que cela signifie pour le Kazakhstan et l’Asie centrale
Le Kazakhstan impose déjà le stockage des données personnelles sur son territoire (loi sur les données personnelles n° 94-V (article 12)), et les systèmes publics et critiques relèvent de dispositions spécifiques de la loi sur l’informatisation. En 2025–2026, le Code numérique et la loi sur l’intelligence artificielle ont été adoptés. Un projet est actuellement en discussion qui permettrait aux administrations de passer au cloud selon le principe Cloud First, à condition que les clés de chiffrement restent au Kazakhstan.
La localisation répond à la question de savoir quelles lois s’appliquent aux données. Leur survie en cas de panne est une autre affaire. Si les données de tout un pays se trouvent physiquement dans quelques grands centres de données, le risque ne fait que se concentrer davantage. C’est exactement l’histoire coréenne : tout était conservé dans le pays, mais dans un seul bâtiment. La panne de Yandex a montré l’autre face : les données des utilisateurs kazakhs étaient au Kazakhstan, mais le service lui-même dépendait de centres de données situés dans un autre pays.
Quelques conclusions pratiques s’imposent. Garder les données dans le pays ne veut pas dire les garder au même endroit : un site de secours à Almaty pour un système à Astana, et inversement, devrait devenir la norme. Le transit compte aussi : une large part du trafic de la région emprunte un petit nombre de routes dorsales, et l’endommagement d’un seul câble peut couper l’accès aux services étrangers même si les centres de données eux-mêmes sont intacts. La panne de Yandex a ajouté un autre scénario : un service utilisé ici peut tomber à cause d’un incident dans un autre pays. Enfin, la résilience peut être intégrée aux achats. Les donneurs d’ordre publics et parapublics sont en droit d’exiger, dans leurs cahiers des charges, un plan de reprise testé, un stockage séparé des sauvegardes et la possibilité d’installer la solution sur leurs propres serveurs.
L’Asie centrale construit son infrastructure numérique plus tard que beaucoup d’autres, et cela a un avantage. Elle peut la concevoir distribuée dès le départ, plutôt que de la reconstruire après une catastrophe majeure, comme la Corée a dû le faire.
Sources
- Drone Strikes Damage Amazon Data Centers in the UAE and Bahrain, Bloomberg Tax, mars 2026
- Amazon says unable to reactivate UAE, Bahrain data centers, septembre 2026
- South Korea data centre fire halts 647 government services, BEST Magazine, octobre 2025
- Microsoft Azure services see major disruption after Red Sea cables cut, TechRadar, septembre 2025
- Data center fire disrupts services at South Korean tech giants Kakao, Naver, Data Center Knowledge, octobre 2022
- Disrupting the first reported AI-orchestrated cyber espionage campaign, Anthropic, novembre 2025
- Microsoft says 8.5M Windows devices were affected by CrowdStrike outage, TechCrunch, juillet 2024
- AWS DynamoDB outage postmortem, InfoQ, novembre 2025
- Data Localization in Kazakhstan: Issue Brief, AmCham Kazakhstan, mai 2026
- Major outage at Yandex (en russe), NGS, 12 octobre 2026
- EU Backs Open Source Matrix For Secure Internal Communications, Open Source For You, février 2026
- Communication on European Tech Sovereignty, COM(2026) 503, European Commission, 3 juin 2026
- European governments opt for open source alternatives to Big Tech encrypted communications, Computer Weekly
- Belgium rolls out Matrix-based messaging app for government, Resilience Media, mars 2026
- “We have faced a serious outage”: head of Yandex Uzbekistan on service disruptions (en russe), Spot, 12 octobre 2026
- Uzum Market outage coincided with a major Yandex Cloud incident (en russe), Podrobno.uz, 8 octobre 2026
- Uzum Market reports services restored (en russe), Gazeta.uz, 10 octobre 2026
- Yandex taxi and courier services stop working in Kazakhstan (en russe), Tengrinews, 11 octobre 2026
Publié pour la première fois sur le blog d'Astana Hub, le 12 octobre 2026.